
引言
在自动驾驶和机器人感知系统里,激光雷达(LiDAR)和相机(Camera)是自动驾驶系统中最常见的一对互补传感器:激光雷达提供准确的三维空间和距离信息,相机提供高分辨率的颜色与纹理。两者融合,才能让系统既“看得远、测得准”,又“认得出、分得清”。
但融合的第一步,不是目标检测,也不是特征提取,而是让两个传感器的数据先对上。

实际工程中,激光雷达点云投影到图像上,常出现标定板边缘偏移、障碍物轮廓错位、远处目标点云框与图像框对不齐。看起来像是融合算法出了问题,但往根上追,很多时候是激光雷达和相机之间的6自由度外参不准。
外参决定了激光雷达坐标系下的一个点,能不能被正确变换到相机坐标系,再通过相机内参投影到图像上的正确位置。可以说,外参是 L-C 融合的第一颗纽扣:这颗纽扣扣错了,后面的检测、识别、定位、跟踪都会跟着歪。
本文就围绕三个问题展开:L-C 外参标定到底在求什么?真正难在哪?康谋的方案如何从联合标定板一路走到重卡实测验证?
一、外参标定到底在求什么?
要理解L-C外参标定,先要回答两个问题:它求的是什么?求准了有什么用?
前者,是一个 6 自由度的刚体变换矩阵,用来描述激光雷达和相机之间的空间相对位置和朝向;后者,则关系到多传感器融合感知中目标检测与识别、环境感知、定位与导航等多个环节。
1、一个矩阵:激光雷达到相机的坐标变换
L-C外参标定的结果是一个 6 自由度的刚体变换矩阵,记作
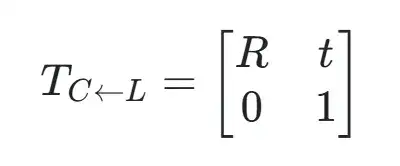
其中R是3×3的旋转矩阵,t是3×1的平移向量,下标C←L表示”把 LiDAR 坐标系下的点变换到相机坐标系”。标定的目标就是求出这个 TC←L。
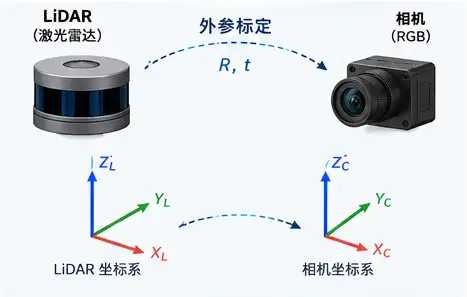
用大白话说就是:R管“朝向”,t管“位置”。求准了它,激光雷达点云才能正确投影到图像上;给像素赋真实深度,也才有可靠依据。
2、两层意义:融合感知的隐形地基
外参标定的意义,不只是“把点云投到图上好看”,它直接关系到融合感知的上限:
- ● 提高目标检测与识别精度:把点云的三维空间信息映射到图像中,为目标检测、识别、定位和跟踪提供更丰富的信息。
- ● 增强环境感知能力:发挥激光雷达测距精度高、相机纹理丰富的互补优势,提升对复杂环境中障碍物、道路边界及其他目标的感知能力。
- ● 保障定位与导航可靠性:为自动驾驶、机器人导航和智能测绘提供准确的多传感器空间关联,减少坐标转换误差带来的定位偏差。
反过来,外参不准会带来一串“失败症状”:点云投到图像边缘偏移、远处目标框漂、融合特征错位、标定残差偏大,严重时定位导航也会被坐标转换误差拖累。后端算法再强,很多时候也只是在“补锅”。
3、核心思路:让两个传感器看同一个已知物体
L-C 外参标定的核心思路并不复杂:让两个传感器同时观察同一个已知物体,从各自观测中解算该物体在各自坐标系下的位置,再用这两组位置关系反推传感器之间的变换。
最常见的方式,是使用一块特制的联合标定板,上面同时布置两种传感器各自擅长识别的特征:
- ● 相机侧:标定板正面贴 ArUco 标记,相机识别后解算标定板相对于相机的三维位姿;
- ● LiDAR 侧:标定板开有精确加工的圆孔,LiDAR 点云检测孔边缘,拟合出孔心在 LiDAR 系下的三维坐标。
一次观测的几何关系如图所示:
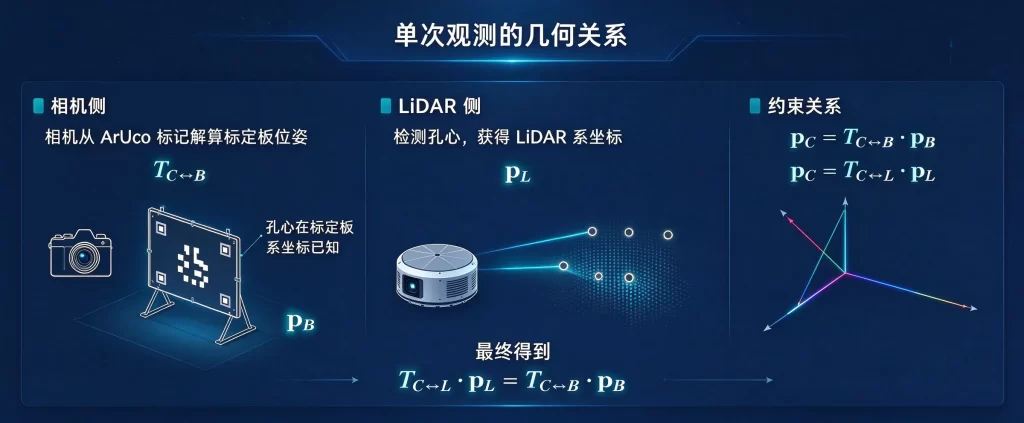
在多个位姿下重复采集,就能构造大量约束方程,再用鲁棒的刚体配准算法求出最优的 $$T_{C \leftarrow L$$。
二、真正难在哪:联合、检测与对应
从上面的思路看,标定似乎很直接:相机看板、激光雷达看孔、联立求解。但工程落地时,真正容易卡住的,往往不是公式,而是特征怎么联合、孔位怎么对应、结果怎么验证。
1、联合标定板:统一观测目标
康谋方案使用的联合标定板,是一块约 1.4 m × 1.0 m 的矩形铝板,表面平整,上面同时布置了两类特征:
- ● 相机特征:板的四个角落各贴一块 ArUco 标记。ArUco 带有内置纠错码,即使部分遮挡或光照不均也能可靠识别;多块标记的好处是,只要能看到至少一块就能解算板位姿,多块同时可见还能互相校验。
- ● 激光雷达特征:板的中部开有 4 个精确加工的圆孔,孔心呈矩形分布。圆孔边界清晰、形状参数可精确拟合,是激光雷达点云检测的理想特征,孔心三维坐标可以通过对孔边缘点做圆拟合高精度提取。
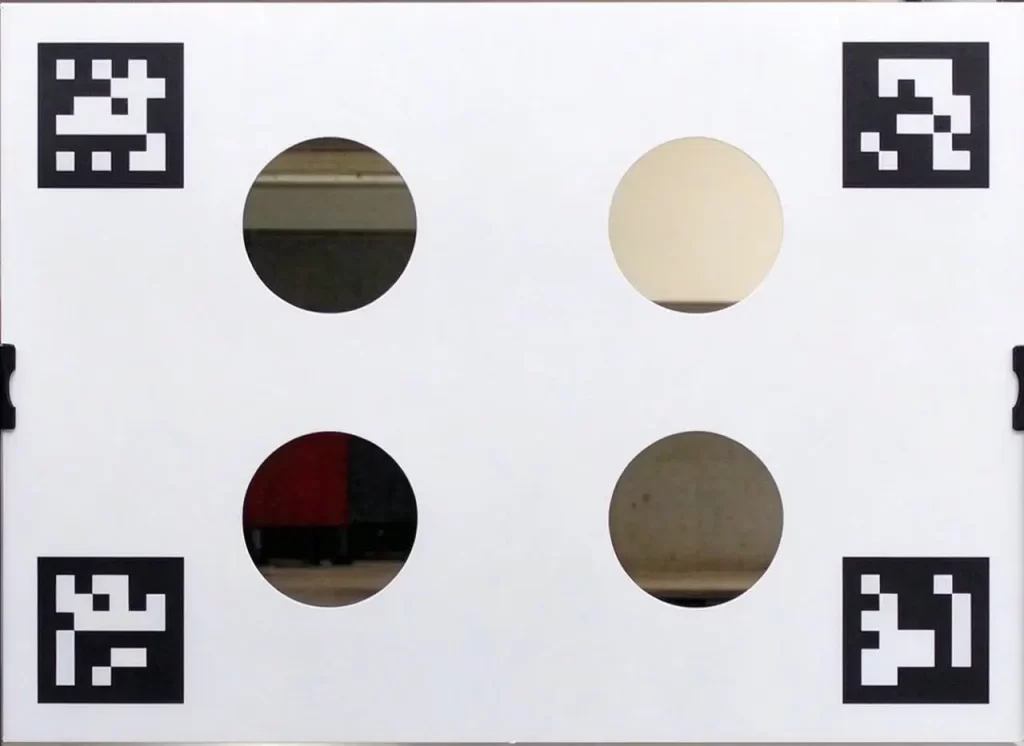
两类特征在同一块板上,保证了相机和激光雷达观察的是同一个物理物体。这是后续建立约束的前提。
2、双侧检测:位姿与孔心
数据采集完成后,对每组位姿同时在相机和激光雷达两侧做特征检测:
- ● 相机侧:图像中检测 ArUco 标记,结合已知标记尺寸和相机内参,解算标定板相对于相机的三维位姿。
- ● 激光雷达侧:先根据粗略的名义外参,反推标定板在激光雷达系中的大致位置,裁剪出感兴趣区域 ROI,再在裁剪后的点云中拟合标定板平面,最终检测并拟合出 4 个圆孔的孔心 3D 坐标。
两组检测都成功的位姿,才会进入后续阶段。这一步看似常规,但它把“相机看到的板”和“激光雷达看到的孔”变成了可以放在一起计算的两组观测。
3、孔位对应:建立唯一映射
激光雷达检测到4个孔心,但并没有“谁是谁”的语义。如果直接按空间排序,不同视角下极易排错,导致解出的外参在不同角度产生明显矛盾。
为了解决这个问题,康谋方案采用了跨位姿一致性匹配,利用多视角联合信息找出正确对应关系。这一步不显眼,却是把“能检测”变成“能解对”的关键。
三、康谋方案:五步闭环与实测验证
将前面的理论难点串联落地,康谋 L-C 联合标定方案可以概括为一个五步闭环。
这套方案打通了从联合特征提取到结果验证的完整流程,并在重卡实车场景中完成了测试。
1、康谋的五步闭环
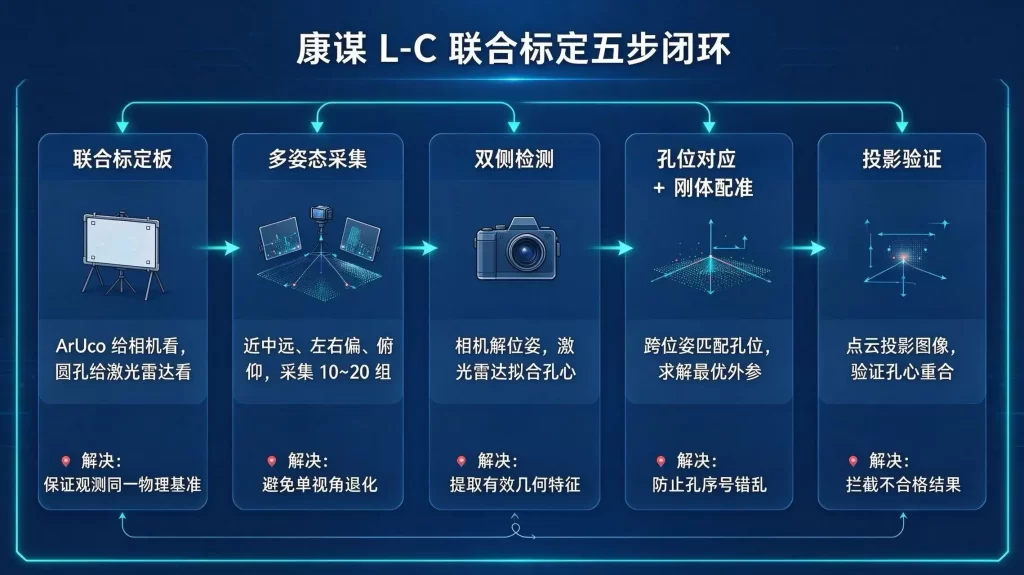
(1)第一步:联合标定板。
ArUco 给相机看,圆孔给激光雷达看,两类特征在同一块铝板上,保证两个传感器观察同一个物理物体。
(2)第二步:多姿态数据采集。
标定需要多组位姿数据。每组位姿对应标定板在车辆前方的一个不同位置和朝向——近、中、远不同距离,正对、左偏、右偏、俯仰等不同角度。采集 10~20 组这样的位姿就足够求解。每组位姿同时保存相机图像和激光雷达点云。
(3)第三步:双侧特征检测。
相机侧检测 ArUco,解算标定板相对相机的三维位姿;激光雷达侧基于粗略名义外参裁剪 ROI,拟合标定板平面并提取 4 个圆孔的孔心 3D 坐标。两组检测都成功的位姿才进入后续阶段。
(4)第四步:跨位姿孔位对应 + 刚体配准。
先通过跨位姿一致性匹配确定 4 个孔心的对应关系。有了对应关系后,每组位姿都能贡献 4 对 3D 点对应(激光雷达孔心 ↔ 板坐标系已知孔心)。把所有有效位姿的点对汇总起来,就构成一个多视角 3D–3D 刚体配准问题。求解器采用标准刚体配准算法,求出最优旋转矩阵和平移向量,使变换后的点与目标点平均距离最小。
(5)第五步:投影验证。
求解出的 $$T_{C \leftarrow L$$ 不能直接使用,必须经过投影验证才能判定为合格:把 LiDAR 点云用解出的变换矩阵转换到相机坐标系,再通过相机内参投影到图像平面。如果投影后的 LiDAR 孔心位置和相机图像中实际看到的位置重合得足够好,说明标定质量达标;如果偏差较大,则说明求解可能失败,需要检查数据质量或增加采集位姿。
全部验证通过后,附带每组位姿的残差统计和投影验证图——后者直观地展示了激光雷达点云投影到图像上的效果,是工程师快速判断标定结果好坏的最直接手段。
2、重卡实测验证
方案是否有效,最终要看实测。
采用康谋L-C联合标定方案,对重型卡车搭载的激光雷达与相机进行联合标定,求解两者之间的外参,包括旋转矩阵 R 和平移向量 T。
在此基础上,利用标定得到的外参将激光雷达采集的三维点云投影至相机图像,实现点云与图像的空间对齐与融合。
实测结果如下图所示,点云与图像中的标定板特征点能够实现较好的对应,验证了该方案在实际场景中的有效性。
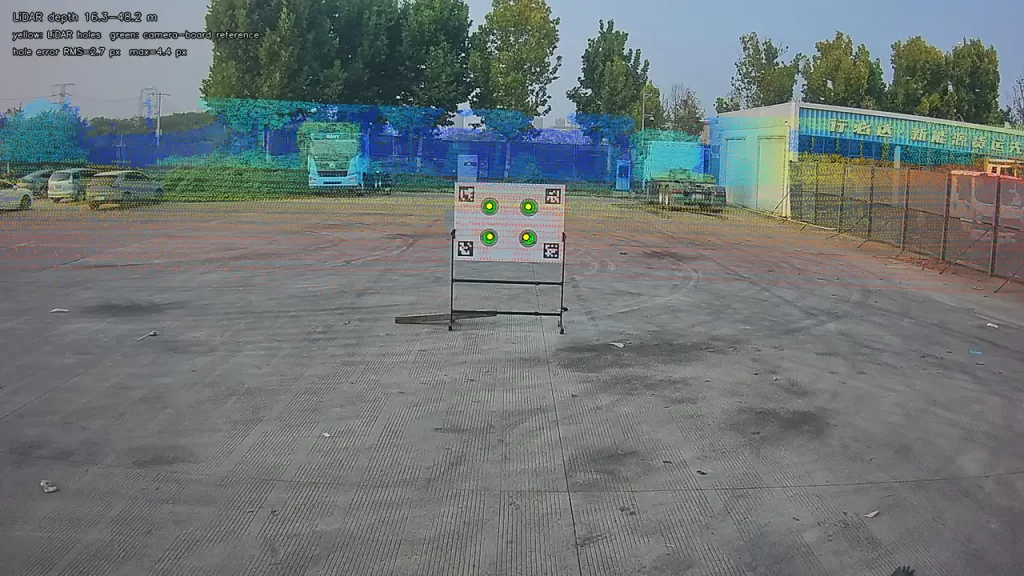
从五步闭环到重卡实测,这套方案的重点不只是“能解出一个矩阵”,而是把标定做成了可采集、可检测、可对应、可求解、可验证的完整流程。
四、总结
L-C 外参标定,看起来只是求一个 6 自由度矩阵,实际考验的是整条工程链路。
康谋方案把标定做成了可采集、可检测、可验证的闭环。从 ArUco + 圆孔的联合标定板,到 10~20 组多姿态数据,再到双侧检测、刚体配准和投影验证,最后在重卡场景完成实测,形成了一条可落地的 L-C 联合标定路径。


